Robisz siedem shotów tej samej kawy latte. Każdy jest nieco inny: niewielka zmiana kąta, niewielka zmiana oświetlenia, Twoja ręka przesunęła się o 2 centymetry. Dla kryptograficznej funkcji skrótu (MD5, SHA-256) te siedem zdjęć jest całkowicie unikalnych - nie pasuje ani jeden bit. Dla ludzkiego oka są zasadniczo identyczne.
Ta rozbieżność między wyjątkowością na poziomie maszyny a podobieństwem postrzeganym przez człowieka to podstawowy problem rozwiązywany przez mieszanie percepcyjne. To podstawowa technologia każdego nowoczesnego narzędzia do czyszczenia duplikatów zdjęć, a zrozumienie jej działania pozwala odkryć, dlaczego niektóre narzędzia czyszczące są znacznie dokładniejsze od innych.
5 poziomów wykrywania podobieństwa zdjęć
Podobieństwo zdjęć działa w pewnym spektrum. Nowoczesne systemy wykrywania wykorzystują jednocześnie wiele technik, każda zoptymalizowana pod kątem innego poziomu:
| Poziom | Metoda wykrywania | Co wyłapuje | Prędkość | Dokładność |
|---|---|---|---|---|
| 1. Identyczny w bajtach | Skrót kryptograficzny (MD5/SHA-256) | Dokładne kopie plików, duplikaty AirDrop | Najszybszy | 100% (ale wąskie) |
| 2. Identyczny w pikselach | Średni skrót (aHash) | Ponownie zapisane lub ponownie zakodowane wersje tego samego obrazu | Bardzo szybko | 85% |
| 3. Wizualnie podobne | Skrót percepcyjny (pHash/dHash) | Wersje przycięte, przefiltrowane lub lekko obrócone | Szybki | 92% |
| 4. Semantycznie podobne | Osadzanie neuronowe (CNN/Vision Transformer) | Ta sama scena pod różnymi kątami, sekwencje zdjęć seryjnych | Umiarkowane | 97% |
| 5. Powiązane koncepcyjnie | Modele multimodalne w stylu CLIP | Różne zdjęcia tego samego tematu lub motywu | Powoli | Zależne od kontekstu |
Dlaczego sumy kontrolne MD5 pomijają 80% duplikatów wizualnych
Skróty kryptograficzne, takie jak MD5 i SHA-256, zostały zaprojektowane do weryfikacji integralności danych, a nie podobieństwa wizualnego. Tworzą skrót o stałej długości, w którym zmiana jednego bitu na wejściu daje zupełnie inny skrót. Oznacza to:
- Ponowne zapisanie pliku JPEG na innym poziomie jakości → zupełnie nowy skrót
- Konwersja HEIC do JPEG → zupełnie nowy skrót
- Przycięcie 2 pikseli od krawędzi → zupełnie nowy skrót
- Dodanie filtra Instagrama → zupełnie nowy skrót
- Zrzuty ekranu tego samego zdjęcia → zupełnie nowy skrót
W rzeczywistych rolkach z kamer tylko około 15-20% duplikatów to dokładne kopie na poziomie bajtów (zazwyczaj z transferów AirDrop lub błędów synchronizacji w chmurze). Pozostałe 80% to wizualne duplikaty wymagające analizy percepcyjnej.
Jak działa percepcyjne mieszanie (pHash i dHash)
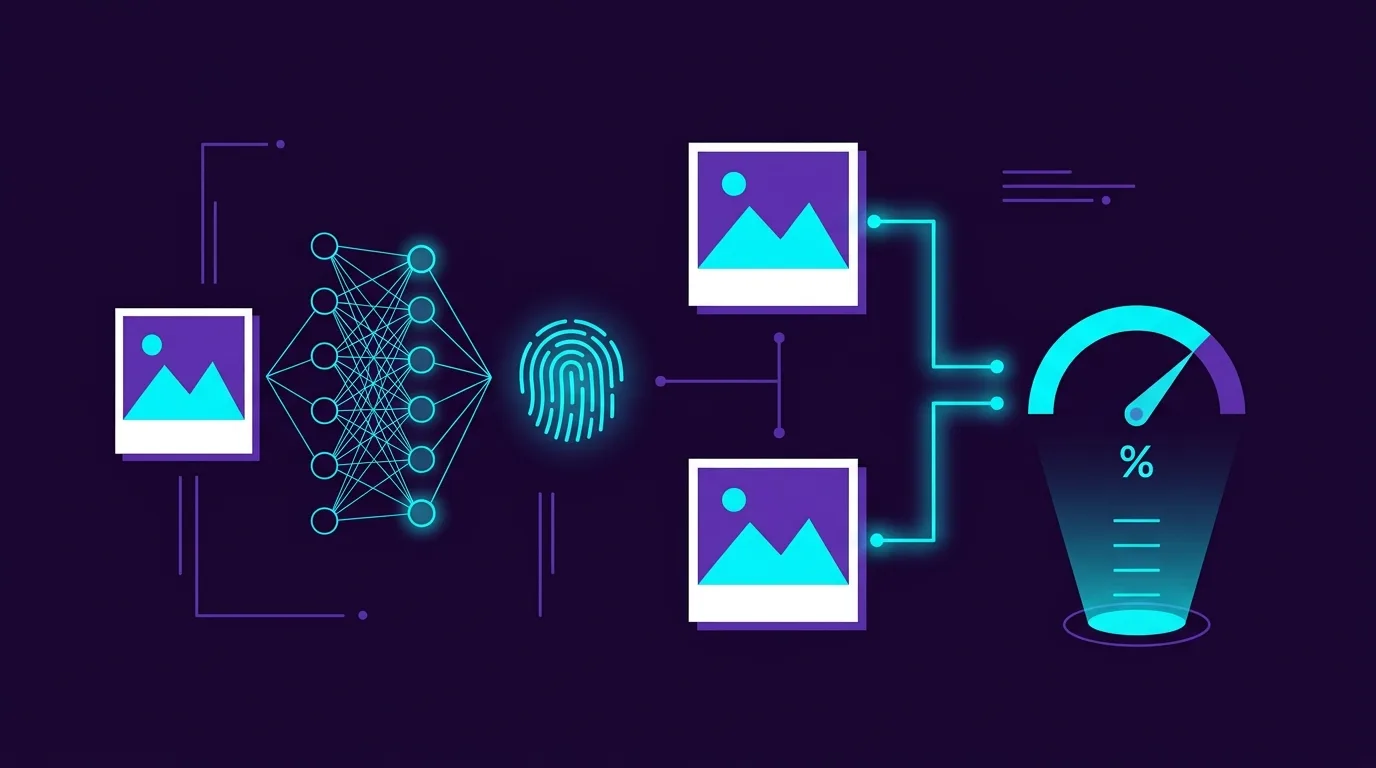
Haszowanie percepcyjne generuje kompaktowy odcisk palca, który rejestruje strukturę wizualną obrazu, a nie jego surową zawartość bajtową. Algorytm działa według ogólnego potoku:
- Zmień rozmiar do małej siatki: Obraz jest zmniejszany do małej rozdzielczości (zazwyczaj 8×8 lub 32×32 piksele), niszcząc drobne szczegóły, ale zachowując ogólną strukturę luminancji.
- Konwertuj na skalę szarości: Informacje o kolorze są odrzucane. Podobieństwo percepcyjne dotyczy przede wszystkim struktury, a nie odcienia - zdjęcie z ciepłym filtrem i zdjęcie z chłodnym filtrem powinny nadal pasować.
- Oblicz gradient lub średnią: w przypadku dHash (hasz różnicowy) każdy piksel jest porównywany ze swoim prawym sąsiadem. W przypadku aHash (średni skrót) każdy piksel jest porównywany ze średnią luminancją siatki. Każde porównanie daje pojedynczy bit: jaśniejszy = 1, ciemniejszy = 0.
- Utwórz binarny odcisk palca: Wynikiem jest 64-bitowy (8×8) lub 1024-bitowy (32×32) ciąg binarny - skrót percepcyjny.
- Porównaj przy użyciu odległości Hamminga: Dwa obrazy są porównywane poprzez zliczenie liczby bitów różniących się między ich skrótami. Odległość Hamminga równa 0 = identyczna struktura. Odległość ≤ 5 (z 64) = wizualnie prawie identyczne. Odległość ≤ 10 = prawdopodobnie podobna.
Dlaczego pHash działa na filtrowanych zdjęciach
Ponieważ algorytm odrzuca kolor i drobne szczegóły w krokach 1-2, wersja zdjęcia przefiltrowana przez Instagram daje prawie taki sam skrót percepcyjny jak oryginał. Wielkoskalowa struktura luminancji - jasne niebo u góry, ciemna ziemia u dołu - pozostaje identyczna niezależnie od gradacji kolorów.
SSIM: pomiar tego, co faktycznie widzi ludzkie oko
Indeks podobieństwa strukturalnego (SSIM) opracowany przez Wanga i in. w 2004 r. wykracza poza hashowanie binarne. Oblicza ciągły wynik podobieństwa (0,0 do 1,0) w oparciu o trzy elementy odzwierciedlające ludzką percepcję wzrokową:
- Porównanie luminancji: Czy średnie poziomy jasności są podobne? (Kompensuje różnice ekspozycji)
- Porównanie kontrastu: czy obrazy mają podobny zakres dynamiczny?
- Porównanie struktury: czy wzorce przestrzenne jasnych i ciemnych obszarów pasują do siebie?
Wynik SSIM powyżej 0,92 zazwyczaj oznacza, że dla większości widzów dwa obrazy są percepcyjnie nierozróżnialne. Nowoczesne narzędzia do czyszczenia zdjęć korzystają z tego progu, aby automatycznie oznaczać prawie duplikaty, zachowując jednocześnie naprawdę różne kompozycje.
Osadzanie neuronowe: granica głębokiego uczenia się
Łączenie percepcyjne zmaga się z podobieństwem semantycznym - zdjęcia tej samej sceny zrobione z różnych pozycji lub sekwencje zdjęć seryjnych, w których obiekt znacznie poruszał się między klatkami. W takich przypadkach sieci neuronowe na urządzeniu (modele splotowe lub modele Vision Transformer) wyodrębniają wielowymiarowe wektory osadzania.
Oto jak to działa: sieć neuronowa przetwarza każde zdjęcie i generuje 512-wymiarowy wektor zmiennoprzecinkowy - zasadniczo 512 liczb kodujących treść semantyczną obrazu. Zdjęcia tego samego zachodu słońca, wykonane w odstępie kilku sekund pod różnymi kątami, tworzą wektory osadzania, które są geometrycznie bliskie w tej 512-wymiarowej przestrzeni.
Podobieństwo mierzy się następnie za pomocą podobieństwa cosinusowego: cosinusa kąta między dwoma wektorami. Cosinus podobieństwa 1,0 = identyczna treść semantyczna. Próg 0,85+ wychwytuje sekwencje wybuchowe, niemal identyczne kompozycje i subtelne różnice, których samo mieszanie percepcyjne mogłoby przeoczyć.
Przetwarzanie na urządzeniu a przetwarzanie w chmurze: wymiar prywatności
Uruchamianie modeli osadzania neuronowego wymaga znacznej mocy obliczeniowej. Niektóre aplikacje do czyszczenia zdjęć przesyłają Twoje obrazy do procesorów graficznych w chmurze w celu analizy - stanowi to ogromne ryzyko dla prywatności. Nowoczesne urządzenia Apple są wyposażone w Neural Engine (16-rdzeniowy w A17 Pro, 5 TOPS w serii M), który umożliwia uruchamianie modeli wizyjnych CoreML całkowicie na urządzeniu. Oznacza to, że 512-wymiarowe osadzanie można obliczyć dla 10 000 zdjęć w czasie krótszym niż 3 minuty bez opuszczania urządzenia przez żadne dane.
| Podejście do przetwarzania | Prędkość (10 tys. zdjęć) | Prywatność | Dokładność |
|---|---|---|---|
| Gpu GPU w chmurze (NVIDIA A100) | 30 sekund | Zdjęcia przesłane na serwery zewnętrzne | Najwyższe (największe modele) |
| Silnik neuronowy na urządzeniu | 2-4 minuty | 100% lokalna, zerowa transmisja sieciowa | Doskonałe (zoptymalizowane modele CoreML) |
| Tylko procesor na urządzeniu | 15-25 minut | 100% lokalnie | Dobry (ograniczona złożoność modelu) |
Zobacz neuronowe wykrywanie duplikatów w działaniu
Swipe Photo Cleaner (Wipe AI) łączy percepcyjne mieszanie w celu szybkiego wstępnego filtrowania z osadzeniem neuronów CoreML na urządzeniu w celu głębokiego grupowania semantycznego. Rezultat: sekwencje zdjęć seryjnych, przefiltrowane kopie i niemal identyczne kompozycje są automatycznie grupowane z wyróżnionym najostrzejszym zdjęciem - a wszystko to przetwarzane lokalnie w silniku neuronowym Twojego urządzenia bez przesyłania ani jednego bajtu do chmury.