Vous prenez sept shots du même café au lait. Chacun est légèrement différent : un léger changement d'angle, un petit changement d'éclairage, votre main a bougé de 2 centimètres. Grâce à une fonction de hachage cryptographique (MD5, SHA-256), ces sept photos sont complètement uniques : aucun bit ne correspond. Pour un œil humain, ils sont essentiellement identiques.
Cet écart entre l'unicité au niveau de la machine et la similarité perçue par l'homme est le problème fondamental que le hachage perceptuel résout. Il s'agit de la technologie de base derrière chaque nettoyeur de photos en double moderne, et comprendre son fonctionnement révèle pourquoi certains nettoyeurs sont considérablement plus précis que d'autres.
5 niveaux de détection de similarité de photos
La similarité des photos opère sur un spectre. Les systèmes de détection modernes utilisent simultanément plusieurs techniques, chacune optimisée pour un niveau différent :
| Niveau | Méthode de détection | Ce qu'il attrape | Vitesse | Précision |
|---|---|---|---|---|
| 1. Octet identique | Hachage cryptographique (MD5/SHA-256) | Copies exactes de fichiers, duplications AirDrop | Le plus rapide | 100 % (mais étroit) |
| 2. Identique aux pixels | Hash moyen (aHash) | Versions réenregistrées ou réencodées de la même image | Très rapide | 85 % |
| 3. Visuellement similaire | Hachage perceptuel (pHash/dHash) | Versions recadrées, filtrées ou légèrement pivotées | Rapide | 92 % |
| 4. Sémantiquement similaire | Incrustations neuronales (CNN/Vision Transformer) | Même scène sous différents angles, séquences en rafale | Modéré | 97 % |
| 5. Lié conceptuellement | Modèles multimodaux de style CLIP | Différentes photos du même sujet ou thème | Lent | Dépend du contexte |
Pourquoi les sommes de contrôle MD5 manquent 80 % des doublons visuels
Les hachages cryptographiques comme MD5 et SHA-256 ont été conçus pour vérifier l'intégrité des données, et non pour la similarité visuelle. Ils produisent un résumé de longueur fixe dans lequel la modification d'un seul bit dans l'entrée produit un hachage complètement différent. Cela signifie :
- Réenregistrer un JPEG à un niveau de qualité différent → hachage entièrement nouveau
- Conversion de HEIC en JPEG → hachage entièrement nouveau
- Recadrage de 2 pixels à partir du bord → hachage entièrement nouveau
- Ajout d'un filtre Instagram → hachage entièrement nouveau
- Captures d'écran de la même photo → hachage entièrement nouveau
Dans les pellicules du monde réel, seulement 15 à 20 % environ des doublons sont des copies exactes au niveau des octets (généralement à partir de transferts AirDrop ou d'erreurs de synchronisation dans le cloud). Les 80 % restants sont des doublons visuels qui nécessitent une analyse perceptuelle.
Comment fonctionne le hachage perceptuel (pHash et dHash)
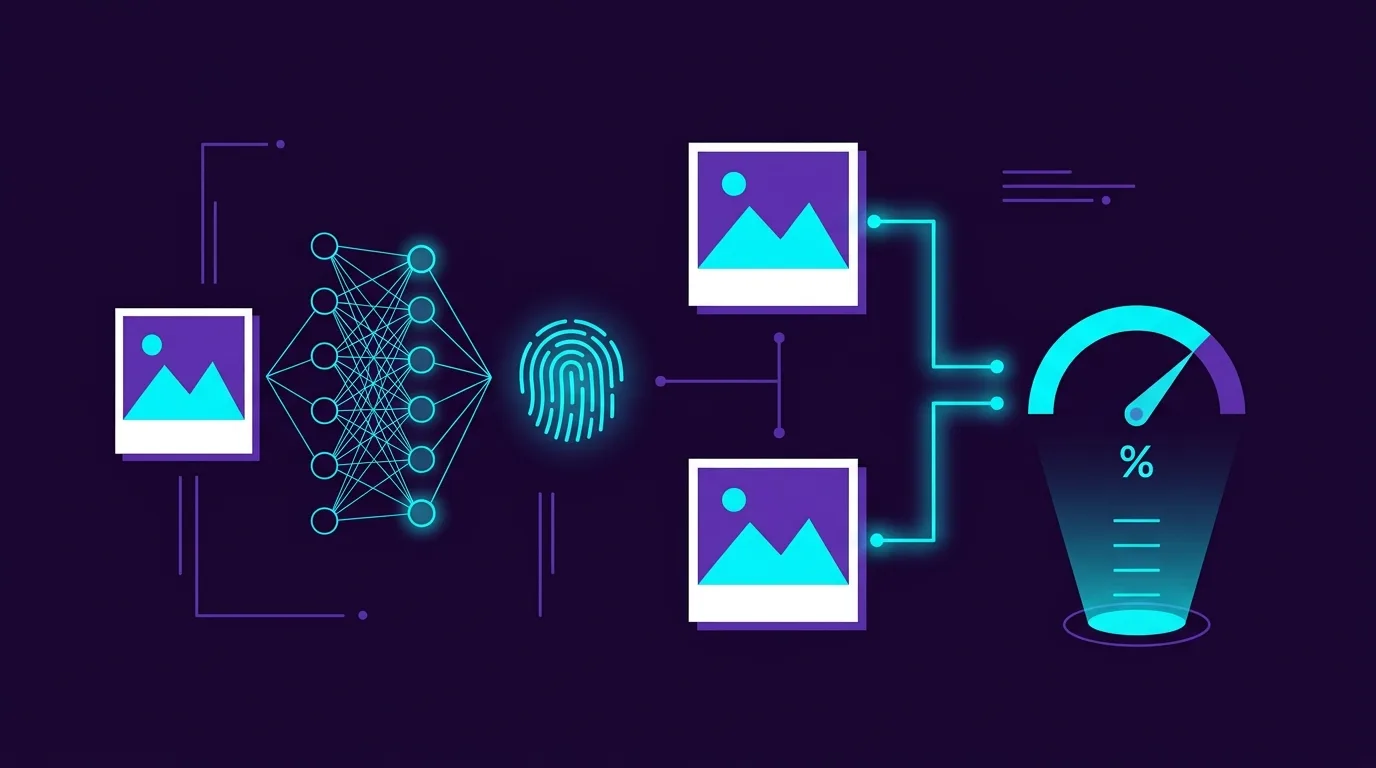
Le hachage perceptuel génère une empreinte digitale compacte qui capture la structure visuelle d'une image plutôt que son contenu brut en octets. L'algorithme suit un pipeline général :
- Redimensionner en une petite grille : L'image est réduite à une petite résolution (généralement 8 × 8 ou 32 × 32 pixels), détruisant les détails fins mais préservant la structure globale de luminance.
- Convertir en niveaux de gris : Les informations de couleur sont ignorées. La similarité perceptuelle concerne principalement la structure et non la teinte : une photo avec un filtre chaud et une photo avec un filtre froid devraient toujours correspondre.
- Calculer le dégradé ou la moyenne : Pour dHash (hachage de différence), chaque pixel est comparé à son voisin droit. Pour aHash (hachage moyen), chaque pixel est comparé à la luminance moyenne de la grille. Chaque comparaison produit un seul bit : plus clair = 1, plus sombre = 0.
- Produire une empreinte binaire : Le résultat est une chaîne binaire de 64 bits (8×8) ou 1 024 bits (32×32) — le hachage perceptuel.
- Comparez à l'aide de la distance de Hamming : Deux images sont comparées en comptant le nombre de bits qui diffèrent entre leurs hachages. Une distance de Hamming de 0 = structure identique. Distance ≤ 5 (sur 64) = visuellement presque identique. Distance ≤ 10 = probablement similaire.
Pourquoi pHash fonctionne sur les photos filtrées
Étant donné que l'algorithme ignore la couleur et les détails fins aux étapes 1 et 2, une version filtrée par Instagram d'une photo produit presque le même hachage perceptuel que l'original. La structure de luminance à grande échelle (ciel clair en haut, fond sombre en bas) reste identique quel que soit l'étalonnage des couleurs.
SSIM : Mesurer ce que l'œil humain voit réellement
L'indice de similarité structurelle (SSIM), développé par Wang et al. en 2004, va au-delà du hachage binaire. Il calcule un score de similarité continu (0,0 à 1,0) basé sur trois composants qui reflètent la perception visuelle humaine :
- Comparaison de luminance : Les niveaux de luminosité moyens sont-ils similaires ? (Compense les différences d'exposition)
- Comparaison du contraste : Les images ont-elles une plage dynamique similaire ?
- Comparaison des structures : Les modèles spatiaux des régions claires et sombres correspondent-ils ?
Un score SSIM supérieur à 0,92 indique généralement que deux images sont perceptuellement indiscernables pour la plupart des spectateurs. Les nettoyeurs de photos modernes utilisent ce seuil pour signaler automatiquement les quasi-doublons tout en préservant des compositions véritablement différentes.
Incorporations neuronales : la frontière du Deep Learning
Le hachage perceptuel a du mal avec la similitude sémantique : photos de la même scène prises depuis différentes positions, ou séquences en rafale où le sujet bougeait de manière significative entre les images. Dans ces cas, les réseaux neuronaux intégrés à l'appareil (modèles convolutifs ou Vision Transformer) extraient des vecteurs d'intégration de grande dimension.
Voici comment cela fonctionne : le réseau neuronal traite chaque photo et génère un vecteur flottant à 512 dimensions – essentiellement 512 nombres qui codent le contenu sémantique de l'image. Des photos du même coucher de soleil, prises à quelques secondes d'intervalle sous différents angles, produisent des vecteurs intégrés géométriquement proches dans cet espace à 512 dimensions.
La similarité est ensuite mesurée à l'aide de la similarité cosinus : le cosinus de l'angle entre deux vecteurs. Une similarité cosinus de 1,0 = contenu sémantique identique. Un seuil de 0,85+ capture des séquences en rafale, des compositions presque identiques et des variations subtiles que le hachage perceptuel seul manquerait.
Traitement sur appareil ou traitement dans le cloud : la dimension de confidentialité
L'exécution de modèles d'intégration neuronale nécessite une puissance de calcul importante. Certaines applications de nettoyage de photos téléchargent vos images sur des GPU cloud pour analyse, ce qui représente un risque énorme pour la vie privée. Les appareils Apple modernes incluent le Neural Engine (16 cœurs sur A17 Pro, 5 TOPS sur la série M), capable d'exécuter des modèles de vision CoreML entièrement sur l'appareil. Cela signifie que des intégrations à 512 dimensions peuvent être calculées pour 10 000 photos en moins de 3 minutes sans qu'aucune donnée ne quitte l'appareil.
| Approche de traitement | Vitesse (10 000 photos) | Confidentialité | Précision |
|---|---|---|---|
| GPU cloud (NVIDIA A100) | 30 secondes | Photos téléchargées sur des serveurs externes | Le plus haut (les plus grands modèles) |
| Moteur neuronal sur l'appareil | 2 à 4 minutes | 100 % local, zéro transmission réseau | Excellent (modèles CoreML optimisés) |
| CPU sur l'appareil uniquement | 15 à 25 minutes | 100% local | Bon (complexité du modèle limitée) |
Voir la détection des doublons neuronaux en action
Swipe Photo Cleaner (Wipe AI) combine un hachage perceptuel pour un filtrage initial rapide avec des intégrations neuronales CoreML sur l'appareil pour un regroupement sémantique approfondi. Résultat : les séquences en rafale, les copies filtrées et les compositions presque identiques sont automatiquement regroupées avec la photo la plus nette mise en évidence, le tout traité localement sur le moteur neuronal de votre appareil sans télécharger un seul octet dans le cloud.