Je maakt zeven shots van dezelfde koffie latte. Ze zijn allemaal net iets anders: een kleine hoekverandering, een kleine lichtverschuiving, je hand bewoog 2 centimeter. Voor een cryptografische hashfunctie (MD5, SHA-256) zijn deze zeven foto's volledig uniek - geen enkel bit komt overeen. Voor het menselijk oog zijn ze in wezen identiek.
Deze kloof tussen uniekheid op machineniveau en door mensen waargenomen gelijkenis is het fundamentele probleem dat perceptuele hashing oplost. Het is de kerntechnologie achter elke moderne opschoonprogramma voor dubbele foto's, en als u begrijpt hoe het werkt, wordt duidelijk waarom sommige opschoonprogramma's aanzienlijk nauwkeuriger zijn dan andere.
5 niveaus van detectie van foto-overeenkomst
Foto-overeenkomst werkt op een spectrum. Moderne detectiesystemen gebruiken meerdere technieken tegelijkertijd, elk geoptimaliseerd voor een ander niveau:
| Niveau | Detectiemethode | Wat het vangt | Snelheid | Nauwkeurigheid |
|---|---|---|---|---|
| 1. Byte-identiek | Cryptografische hash (MD5/SHA-256) | Exacte bestandskopieën, AirDrop-duplicaten | Snelste | 100% (maar beperkt) |
| 2. Pixel-identiek | Gemiddelde hash (aHash) | Opnieuw opgeslagen of opnieuw gecodeerde versies van dezelfde afbeelding | Zeer snel | 85% |
| 3. Visueel vergelijkbaar | Perceptuele hash (pHash/dHash) | Bijgesneden, gefilterde of enigszins geroteerde versies | Snel | 92% |
| 4. Semantisch vergelijkbaar | Neurale inbedding (CNN/Vision Transformer) | Dezelfde scène vanuit verschillende hoeken, burst-reeksen | Gemiddeld | 97% |
| 5. Conceptueel gerelateerd | Multimodale modellen in CLIP-stijl | Verschillende foto's van hetzelfde onderwerp of thema | Langzaam | Contextafhankelijk |
Waarom MD5-checksums 80% van de visuele duplicaten missen
Cryptografische hashes zoals MD5 en SHA-256 zijn ontworpen voor verificatie van de gegevensintegriteit, niet voor visuele gelijkenis. Ze produceren een samenvatting met een vaste lengte, waarbij het veranderen van een enkele bit in de invoer een compleet andere hash oplevert. Dit betekent:
- Een JPEG opnieuw opslaan op een ander kwaliteitsniveau → geheel nieuwe hash
- HEIC naar JPEG converteren → geheel nieuwe hash
- 2 pixels vanaf de rand bijsnijden → geheel nieuwe hash
- Een Instagram-filter toevoegen → geheel nieuwe hash
- Schermafbeeldingen van dezelfde foto → geheel nieuwe hash
In echte camerabeelden zijn slechts ongeveer 15-20% van de duplicaten exacte kopieën op byteniveau (meestal afkomstig van AirDrop-overdrachten of cloudsynchronisatiefouten). De resterende 80% zijn visuele duplicaten die perceptuele analyse vereisen.
Hoe perceptuele hashing werkt (pHash en dHash)
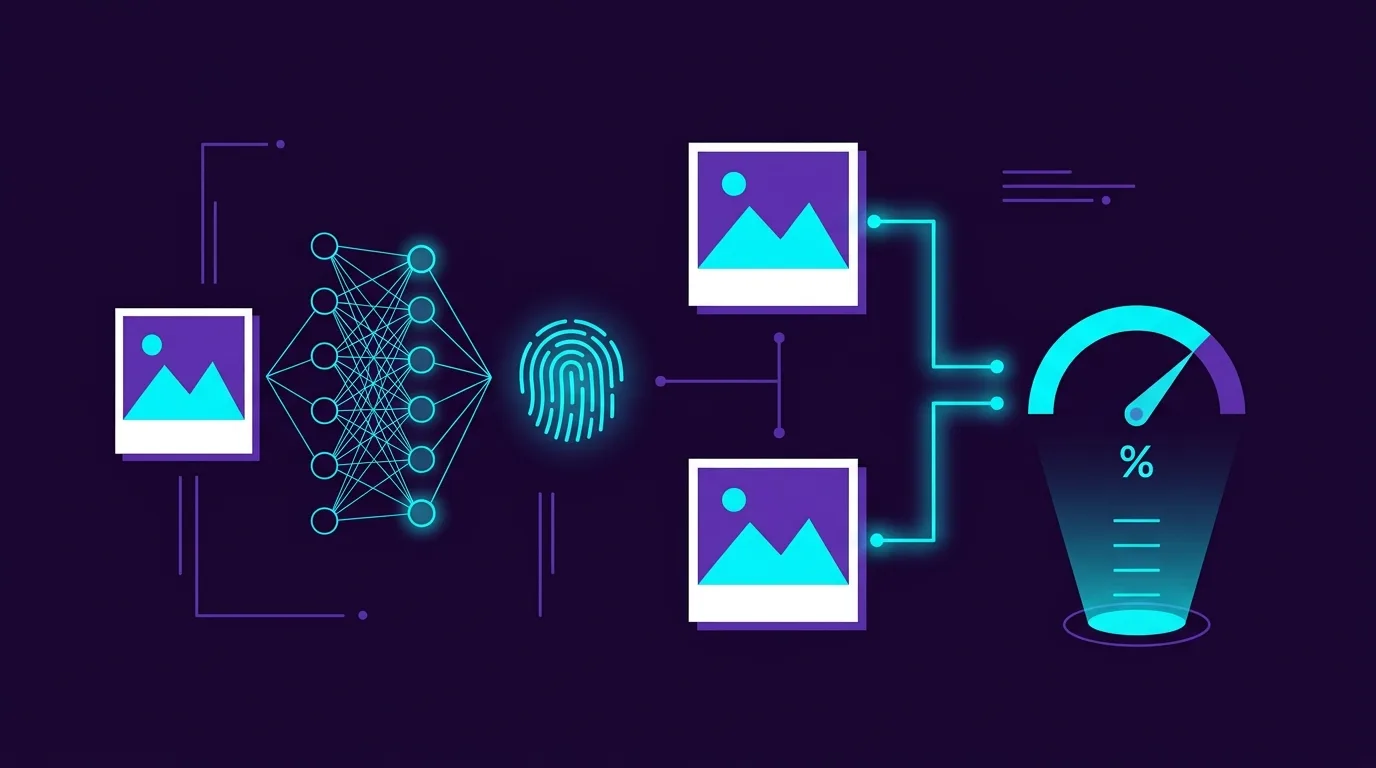
Perceptuele hashing genereert een compacte vingerafdruk die de visuele structuur van een afbeelding vastlegt in plaats van de onbewerkte byte-inhoud. Het algoritme volgt een algemene pijplijn:
- Formaat wijzigen naar een klein raster: De afbeelding wordt verkleind naar een kleine resolutie (meestal 8×8 of 32×32 pixels), waardoor fijne details verloren gaan, maar de algehele helderheidsstructuur behouden blijft.
- Converteren naar grijstinten: Kleurinformatie wordt genegeerd. Perceptuele gelijkenis gaat vooral over de structuur, niet over de tint. Een foto met een warm filter en een foto met een koel filter moeten nog steeds overeenkomen.
- Bereken de gradiënt of het gemiddelde: Voor dHash (verschilhash) wordt elke pixel vergeleken met zijn rechterbuurman. Voor aHash (gemiddelde hash) wordt elke pixel vergeleken met de gemiddelde luminantie van het raster. Elke vergelijking levert één bit op: helderder = 1, donkerder = 0.
- Maak binaire vingerafdruk: Het resultaat is een 64-bits (8×8) of 1024-bits (32×32) binaire string: de perceptuele hash.
- Vergelijken met Hamming-afstand: Twee afbeeldingen worden vergeleken door te tellen hoeveel bits er tussen hun hashes verschillen. Een Hamming-afstand van 0 = identieke structuur. Afstand ≤ 5 (van de 64) = visueel vrijwel identiek. Afstand ≤ 10 = waarschijnlijk vergelijkbaar.
Waarom pHash werkt op gefilterde foto's
Omdat het algoritme in stap 1-2 kleur en fijne details negeert, produceert een door Instagram gefilterde versie van een foto bijna dezelfde perceptuele hash als het origineel. De grootschalige luminantiestructuur - heldere lucht bovenaan, donkere grond onderaan - blijft identiek, ongeacht de kleurgradatie.
SSIM: meten wat het menselijk oog feitelijk ziet
De Structurele Gelijkenis Index (SSIM), ontwikkeld door Wang et al. in 2004 gaat verder dan binaire hashing. Het berekent een continue gelijkenisscore (0,0 tot 1,0) op basis van drie componenten die de menselijke visuele perceptie weerspiegelen:
- Helderheidsvergelijking: Zijn de gemiddelde helderheidsniveaus vergelijkbaar? (Compenseert belichtingsverschillen)
- Contrastvergelijking: Hebben de afbeeldingen een vergelijkbaar dynamisch bereik?
- Structuurvergelijking: Komen de ruimtelijke patronen van lichte en donkere gebieden overeen?
Een SSIM-score boven 0,92 geeft doorgaans aan dat twee afbeeldingen voor de meeste kijkers perceptueel niet van elkaar te onderscheiden zijn. Moderne fotoreinigers gebruiken deze drempel om bijna-duplicaten automatisch te markeren, terwijl echt verschillende composities behouden blijven.
Neurale inbedding: de grens van diep leren
Perceptuele hashing heeft moeite met semantische gelijkenis: foto's van dezelfde scène genomen vanuit verschillende posities, of burst-reeksen waarbij het onderwerp aanzienlijk tussen frames bewoog. Voor deze gevallen extraheren neurale netwerken op het apparaat (convolutionele of Vision Transformer-modellen) hoogdimensionale inbeddingsvectoren.
Zo werkt het: het neurale netwerk verwerkt elke foto en voert een 512-dimensionale floatvector uit - in wezen 512 getallen die de semantische inhoud van de afbeelding coderen. Foto's van dezelfde zonsondergang, seconden na elkaar genomen vanuit verschillende hoeken, produceren inbeddingsvectoren die geometrisch dichtbij elkaar liggen in deze 512-dimensionale ruimte.
De gelijkenis wordt vervolgens gemeten met behulp van cosinusgelijkenis: de cosinus van de hoek tussen twee vectoren. Een cosinusovereenkomst van 1,0 = identieke semantische inhoud. Een drempel van 0,85+ vangt burst-sequenties, vrijwel identieke composities en subtiele variaties op die alleen perceptuele hashing zouden missen.
On-device versus cloudverwerking: de privacydimensie
Het uitvoeren van neurale inbeddingsmodellen vereist aanzienlijke rekenkracht. Sommige apps voor het opschonen van foto's uploaden uw afbeeldingen naar cloud-GPU's voor analyse - een enorm privacyrisico. Moderne Apple-apparaten beschikken over de Neural Engine (16-core op de A17 Pro, 5 TOPS op de M-serie), waarmee CoreML vision-modellen volledig op het apparaat kunnen worden uitgevoerd. Dit betekent dat 512-dimensionale insluitingen voor 10.000 foto's in minder dan 3 minuten kunnen worden berekend, zonder dat er gegevens het apparaat verlaten.
| Verwerkingsaanpak | Snelheid (10.000 foto's) | Privacy | Nauwkeurigheid |
|---|---|---|---|
| Cloud-GPU (NVIDIA A100) | 30 seconden | Foto's geüpload naar externe servers | Hoogste (grootste modellen) |
| Neural Engine op het apparaat | 2-4 minuten | 100% lokaal, geen netwerktransmissie | Uitstekend (geoptimaliseerde CoreML-modellen) |
| Alleen CPU op apparaat | 15-25 minuten | 100% lokaal | Goed (beperkte modelcomplexiteit) |
Zie neurale dubbele detectie in actie
Swipe Photo Cleaner (Wipe AI) combineert perceptuele hashing voor snelle initiële filtering met CoreML neurale inbedding op het apparaat voor diepgaande semantische groepering. Het resultaat: burst-reeksen, gefilterde kopieën en vrijwel identieke composities worden automatisch geclusterd, waarbij de scherpste foto wordt gemarkeerd - allemaal lokaal verwerkt op de Neural Engine van uw apparaat zonder ook maar één byte naar de cloud te uploaden.
iPhone Opslagruimte & Dubbele Foto's Calculator
Bereken hoeveel gigabytes je direct kunt vrijmaken door dubbele foto's, live photos en video's op te schonen.
4K Video Compressie & Opslag Calculator
Bereken hoeveel gigabytes je bespaart door video's van H.264 naar HEVC (H.265) te converteren.