Ви п'єте сім порцій однієї кави латте. Кожен трохи відрізняється: незначна зміна кута, невелике зміщення освітлення, ваша рука перемістилася на 2 сантиметри. Для криптографічної хеш-функції (MD5, SHA-256) ці сім фотографій є абсолютно унікальними - жоден біт не збігається. Для людського ока вони фактично ідентичні.
Цей розрив між унікальністю на рівні машини та подібністю, яку сприймає людина, є основною проблемою, яку вирішує перцептивне хешування. Це основна технологія, що лежить в основі кожного сучасного засобу очищення дублікатів фотографій, і розуміння того, як він працює, показує, чому деякі засоби очищення значно точніші за інші.
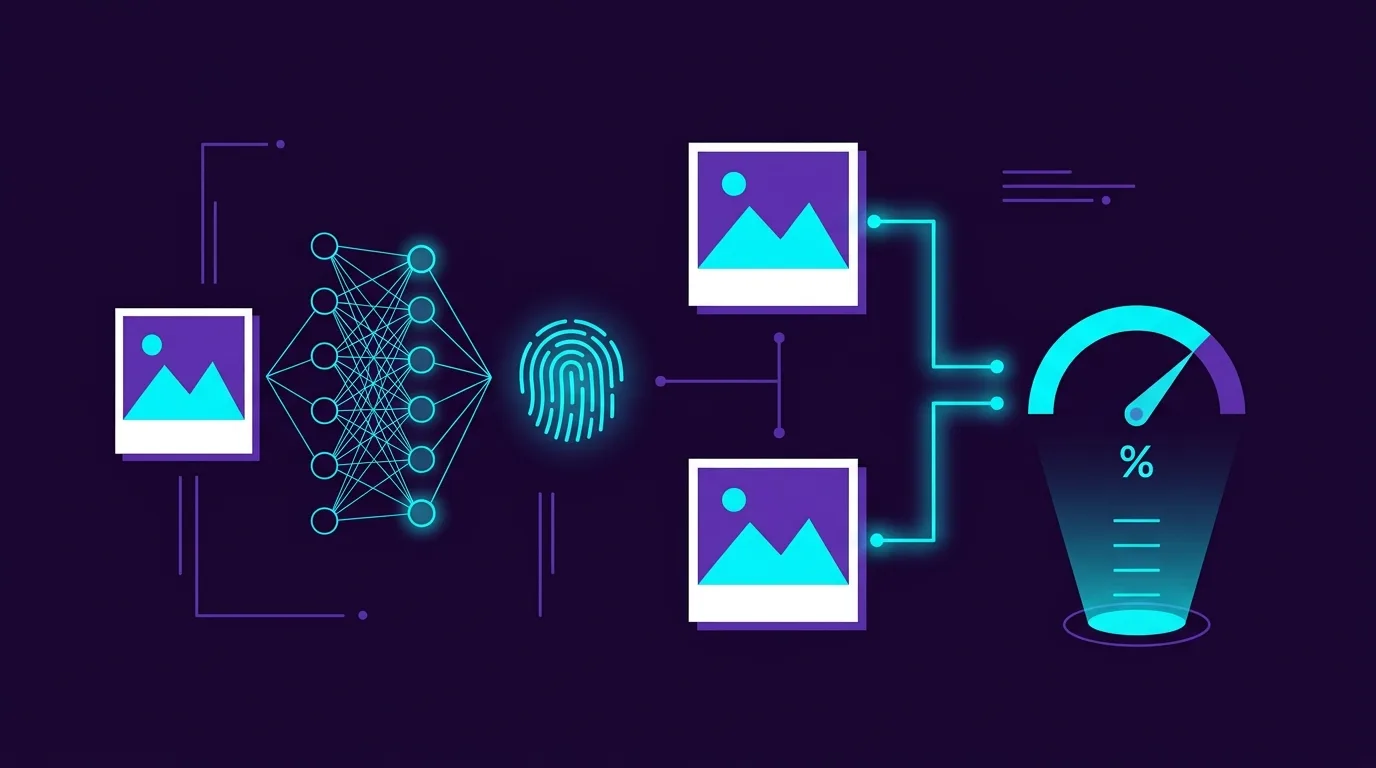
5 рівнів визначення схожості фотографій
Подібність фото залежить від спектру. Сучасні системи виявлення використовують кілька методів одночасно, кожен оптимізований для різного рівня:
| Рівень | Метод виявлення | Що вловлює | Швидкість | Точність |
|---|---|---|---|---|
| 1. Байтоподібний | Криптографічний хеш (MD5/SHA-256) | Точні копії файлів, дублікати AirDrop | Найшвидший | 100% (але вузький) |
| 2. Піксельна ідентичність | Середній хеш (aHash) | Повторно збережені або повторно закодовані версії того самого зображення | Дуже швидко | 85% |
| 3. Візуально схожі | Перцептивний хеш (pHash/dHash) | Обрізані, відфільтровані або дещо повернуті версії | Швидко | 92% |
| 4. Семантично подібні | Нейронні вбудовування (CNN/Vision Transformer) | Та сама сцена з різних ракурсів, серія серії | Помірний | 97% |
| 5. Концептуально пов’язані | Мультимодальні моделі у стилі CLIP | Різні фотографії однієї теми чи теми | Повільно | Залежить від контексту |
Чому контрольні суми MD5 пропускають 80% візуальних дублікатів
Криптографічні хеші, такі як MD5 і SHA-256, розроблено для перевірки цілісності даних, а не для візуальної схожості. Вони створюють дайджест фіксованої довжини, де зміна одного біта у вхідних даних створює зовсім інший хеш. Це означає:
- Повторне збереження JPEG на іншому рівні якості → абсолютно новий хеш
- Перетворення HEIC на JPEG → повністю новий хеш
- Обрізання 2 пікселів від краю → абсолютно новий хеш
- Додавання фільтра Instagram → абсолютно новий хеш
- Скріншоти тієї самої фотографії → повністю новий хеш
У реальних фотознімках лише близько 15-20% дублікатів є точними копіями рівня байтів (зазвичай через передачу AirDrop або помилки синхронізації з хмарою). Решта 80% є візуальними дублікатами, які потребують перцептивного аналізу.
Як працює перцептивне хешування (pHash і dHash)
Перцепційне хешування генерує компактний відбиток, який фіксує візуальну структуру зображення, а не його необроблений байтовий вміст. Алгоритм працює за загальним конвеєром:
- Змінити розмір до дрібної сітки: зображення зменшується до невеликої роздільної здатності (зазвичай 8×8 або 32×32 пікселів), знищуючи дрібні деталі, але зберігаючи загальну структуру яскравості.
- Перетворити на градації сірого: інформація про колір відхиляється. Схожість сприйняття залежить насамперед від структури, а не відтінку - фото з теплим фільтром і фотографія з холодним фільтром все одно мають збігатися.
- Обчислити градієнт або середнє значення: для dHash (хеш різниці) кожен піксель порівнюється зі своїм правим сусідом. Для aHash (середній хеш) кожен піксель порівнюється із середньою яскравістю сітки. Кожне порівняння створює один біт: яскравіше = 1, темніше = 0.
- Створення двійкового відбитка: Результатом є 64-бітний (8×8) або 1024-бітний (32×32) двійковий рядок - перцептивний хеш.
- Порівняти за допомогою відстані Хеммінга: два зображення порівнюються шляхом підрахунку кількості бітів, які відрізняються між їхніми хешами. Відстань Хеммінга 0 = ідентична структура. Відстань ≤ 5 (із 64) = візуально майже ідентична. Відстань ≤ 10 = ймовірно подібна.
Чому pHash працює на відфільтрованих фотографіях
Оскільки алгоритм відкидає колір і дрібні деталі на кроці 1-2, версія фотографії, відфільтрована Instagram, створює майже такий самий хеш сприйняття, як і оригінал. Масштабна структура яскравості - світле небо вгорі, темна земля внизу - залишається незмінною незалежно від градації кольорів.
SSIM: вимірювання того, що насправді бачить людське око
Індекс структурної подібності (SSIM), розроблений Wang et al. у 2004 році виходить за рамки двійкового хешування. Він обчислює безперервну оцінку подібності (від 0,0 до 1,0) на основі трьох компонентів, які відображають людське візуальне сприйняття:
- Порівняння яскравості: чи схожі середні рівні яскравості? (Компенсує різницю експозиції)
- Порівняння контрастності: чи мають зображення подібний динамічний діапазон?
- Порівняння структури: чи збігаються просторові моделі світлих і темних областей?
Показник SSIM вище 0,92 зазвичай означає, що більшість глядачів не розрізняють два зображення. Сучасні засоби очищення фотографій використовують цей поріг, щоб автоматично позначати майже дублікати, зберігаючи дійсно різні композиції.
Нейронні вбудовування: кордон глибокого навчання
Перцепційне хешування має проблеми з семантичною подібністю - фотографії однієї сцени, зроблені з різних позицій, або серійні послідовності, коли об’єкт значно переміщався між кадрами. У цих випадках нейронні мережі на пристрої (конволюційні моделі або моделі Vision Transformer) витягують багатовимірні вектори вбудовування.
Ось як це працює: нейронна мережа обробляє кожну фотографію та виводить 512-вимірний плаваючий вектор - фактично 512 чисел, які кодують семантичний вміст зображення. Фотографії одного заходу сонця, зроблені з інтервалом у кілька секунд під різними кутами, створюють геометрично близькі вбудовані вектори в цьому 512-вимірному просторі.
Подібність вимірюється за допомогою косинусної подібності: косинуса кута між двома векторами. Косинус подібності 1,0 = ідентичний семантичний вміст. Поріг 0,85+ вловлює пакетні послідовності, майже ідентичні композиції та тонкі варіації, які не помічає лише перцепційне хешування.
Обробка на пристрої проти хмарної обробки: вимір конфіденційності
Запуск моделей нейронного вбудовування вимагає значної обчислювальної потужності. Деякі програми для очищення фотографій завантажують ваші зображення в хмарні графічні процесори для аналізу - величезний ризик конфіденційності. Сучасні пристрої Apple включають Neural Engine (16-ядерний на A17 Pro, 5 TOPS на M-серії), здатний запускати моделі зору CoreML повністю на пристрої. Це означає, що 512-вимірні вставки можна обчислити для 10 000 фотографій менш ніж за 3 хвилини без жодних даних, що залишають пристрій.
| Підхід до обробки | Швидкість (10 тисяч фотографій) | Конфіденційність | Точність |
|---|---|---|---|
| Графічний процесор Cloud (NVIDIA A100) | 30 секунд | Фотографії, завантажені на зовнішні сервери | Найвищий (найбільші моделі) |
| In-Device Neural Engine | 2-4 хвилини | 100% локальна, нульова мережева передача | Відмінно (оптимізовані моделі CoreML) |
| Лише центральний процесор на пристрої | 15-25 хвилин | 100% локальний | Добре (обмежена складність моделі) |
Дивіться функцію виявлення нейронних дублікатів у дії
Swipe Photo Cleaner (Wipe AI) поєднує сприйнятливе хешування для швидкої початкової фільтрації з нейронними вбудованими на пристрої CoreML для глибокого семантичного групування. Результат: серійні серії, відфільтровані копії та майже ідентичні композиції автоматично групуються з виділенням найчіткіших фотографій - усе це обробляється локально на Neural Engine вашого пристрою без завантаження жодного байта в хмару.
Калькулятор Памяти iPhone & Экономии на iCloud
Оцените объем свободной памяти и сумму, которую можно сэкономить на подписке iCloud